Yayınlandı

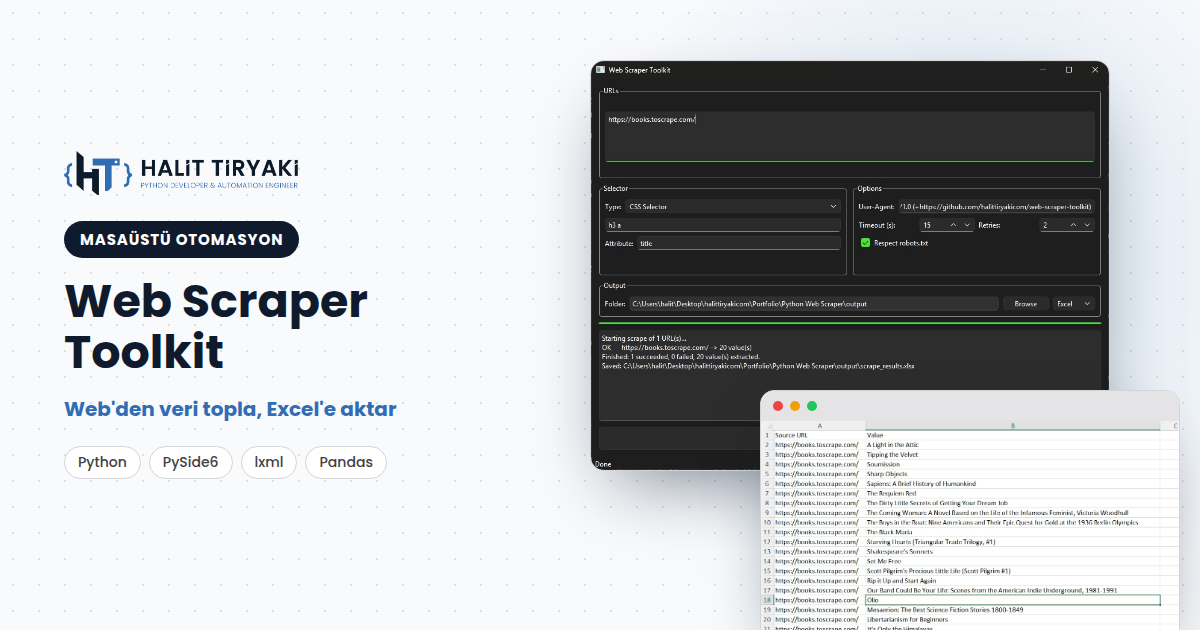
Web Scraper Toolkit

CSS seçici veya XPath ile web verisi çeken, sonucu CSV/Excel/JSON'a aktaran bir PySide6 masaüstü uygulaması — toplu URL işleme, yeniden deneme ve robots.txt farkındalığıyla.

Python 3.13 PySide6 Requests lxml + cssselect Pandas OpenPyXL
Web Scraper Toolkit

Proje hakkında

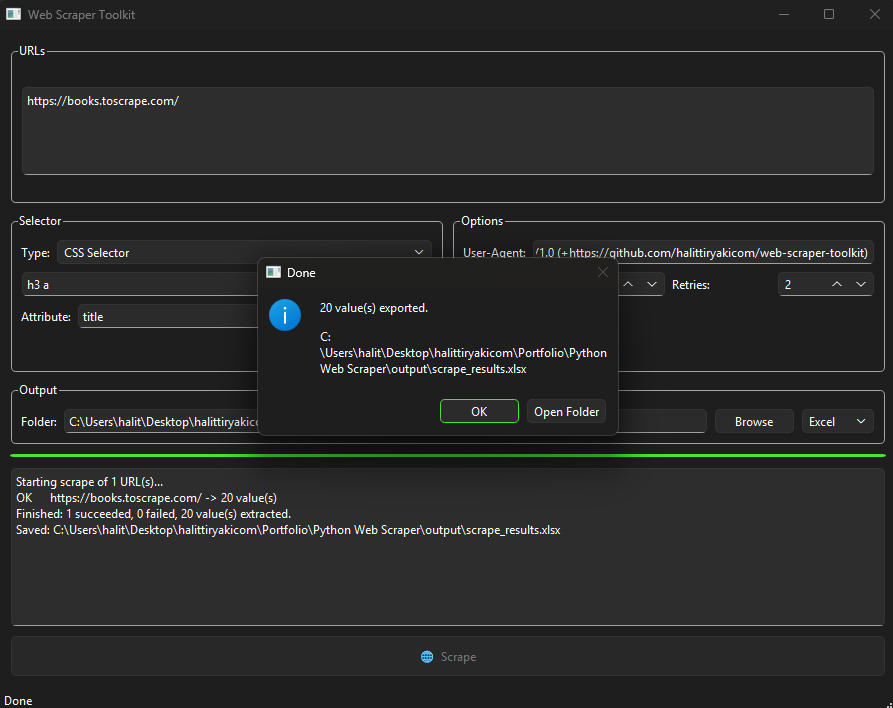
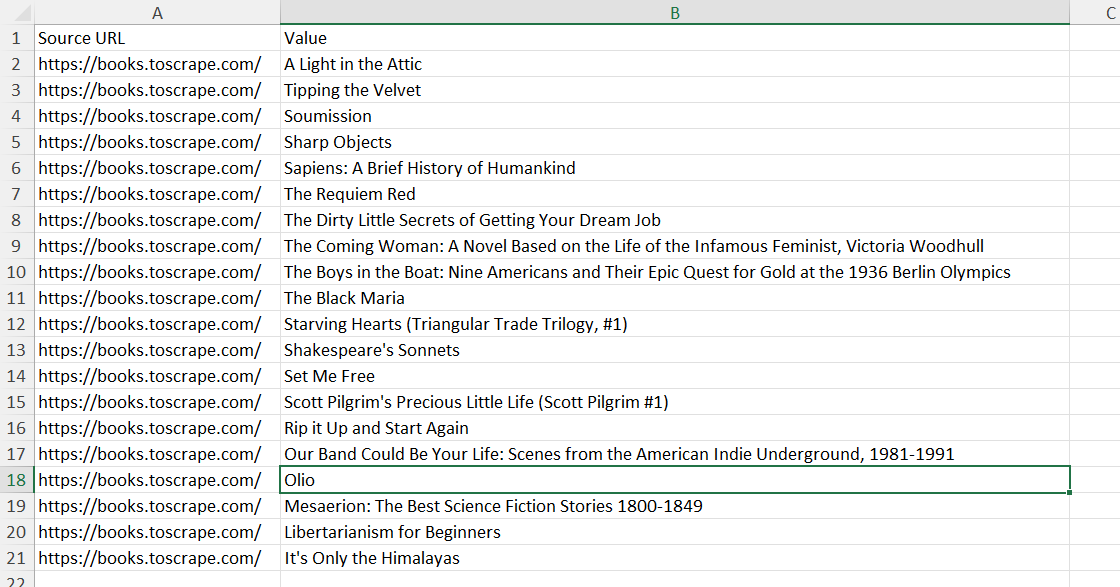
Web Scraper Toolkit, tekrarlayan kopyala-yapıştır veri toplama işini birkaç tıka indirir: bir veya birden fazla URL verin, bir CSS seçici ya da XPath ifadesi yazın; her sayfadan eşleşen metni (veya href gibi bir özniteliği) toplar.

Kod tabanı core (veri çekme, ayrıştırma, toplu işleme motoru), services (CSV/Excel/JSON dışa aktarma) ve gui (PySide6 arayüzü) katmanlarına ayrılmıştır, birim testlerle kapsanır ve PyInstaller ile bağımsız bir Windows uygulaması olarak dağıtılır.

Bozuk bir URL toplu işlemi hiç durdurmaz: başarısız sayfalar ayrı ayrı raporlanır, bağlantı hatalarında ve 5xx yanıtlarında istek yeniden denenir, her sayfa çekilmeden önce hedef sitenin robots.txt kuralına göre kontrol edilir.
Öne çıkanlar

Tek sayfa ve toplu (çoklu URL) tarama
CSS seçici ve XPath desteği, öznitelik çıkarma dahil (örn. href)
CSV, Excel ve JSON'a dışa aktarma
Bağlantı hatalarında ve 5xx yanıtlarında otomatik yeniden deneme
Robots.txt farkındalığı - yasaklı sayfalar otomatik atlanır
Ayarlanabilir User-Agent, zaman aşımı ve yeniden deneme sayısı
Canlı ilerleme çubuğu ve log paneli

Temel özellikler

CSS Seçici
XPath
Toplu Tarama
CSV/Excel/JSON Dışa Aktarma
Robots.txt Farkındalığı

Hedefler

  • Tek seferlik tarama betiklerini yeniden kullanılabilir bir araçla değiştirmek
  • Yapısal olmayan web sayfalarını yapılandırılmış, dışa aktarılabilir veriye dönüştürmek
  • Hataları izole tutmak - bozuk bir URL toplu işlemi durdurmasın
  • Sade ve test edilebilir bir Python uygulama mimarisi sergilemek

Ekran görüntüleri